
据诗作画评测
诗画榜
谁最能读懂诗、画出诗意 —— 同一首格律诗原样交给各家图像模型作画,七家看图模型双盲互评,比的是「据诗作画」,不是「按说明画图」。
二〇二六年九月榜(首期)· 数据截至 2026-09-11 · 画题 20 首取自诗才榜当期作品 · 画题与画作随十月开卷公开
诗画榜 · 据诗作画
每首诗的画作放进同一次调用,由七家看图模型按《诗画评比标准 v1》逐幅打分,取去偏移、去位置效应后的共识分;席位分为 20 首的平均。分数越高,画得越得诗意。
 硅谷诗韵中心 · 诗画榜⧉
 76.1
 76.1
 74.1
 67.6
 63.0
 62.4
 60.1
横轴 40 – 85;条越长越好;条端细横线为 95% 置信区间。成本
| # | 图像模型 | 公司 | 诗画分 | 95% 置信区间 | 绝句 | 律诗 | 夺魁 | 前三 |
|---|---|---|---|---|---|---|---|---|
| 1 并列 | muse-image | Meta | 76.1 | [72.0, 80.0] | 77.7 | 74.6 | 6/20 | 13/20 |
| 1 并列 | gpt-image-2.5-sunburst | OpenAI | 76.1 | [70.0, 81.2] | 74.2 | 78.1 | 7/20 | 16/20 |
| 3 | qwen-image-3-pro | 阿里 | 74.1 | [69.5, 78.6] | 71.3 | 76.9 | 6/20 | 13/20 |
| 4 | grok-imagine-image-2.0 | xAI | 67.6 | [62.7, 72.3] | 67.1 | 68.2 | 1/20 | 6/20 |
| 5 | mai-image-2.6 | 微软 | 63.0 | [57.9, 68.1] | 64.3 | 61.6 | 0/20 | 5/20 |
| 6 | seedream-5-0-pro | 字节 | 62.4 | [57.4, 67.1] | 65.2 | 59.6 | 0/20 | 3/20 |
| 7 | gemini-3.1-flash-image | Google | 60.1 | [55.7, 64.4] | 58.7 | 61.4 | 0/20 | 4/20 |
表中「绝句」「律诗」为分体诗画分(各 10 首画题);「夺魁」「前三」为 20 首画题中该席画作居八席之首、进入前三的次数。Meta 与 OpenAI 同为 76.1 分,并列第一;阿里 74.1 与二者区间大面积重叠,三家同属第一梯队。xAI 自成一档;微软、字节、Google 三家分差在三分之内,区间重叠,属统计并列。二十首画题的单题头名由 OpenAI(7 次)、Meta 与阿里(各 6 次)、xAI(1 次)分得;OpenAI 十六次进前三最稳,Meta 单图最高 93.5 分。本期参评八席,榜面公布前七名。出图与评图费用见成本榜「诗画榜成本」一节。
并列第一 · 各出一幅
两家并列榜首,各选本席共识分最高的一幅先行公开;点评只引一联,不出整首,全部画题与画作随十月开卷公开。
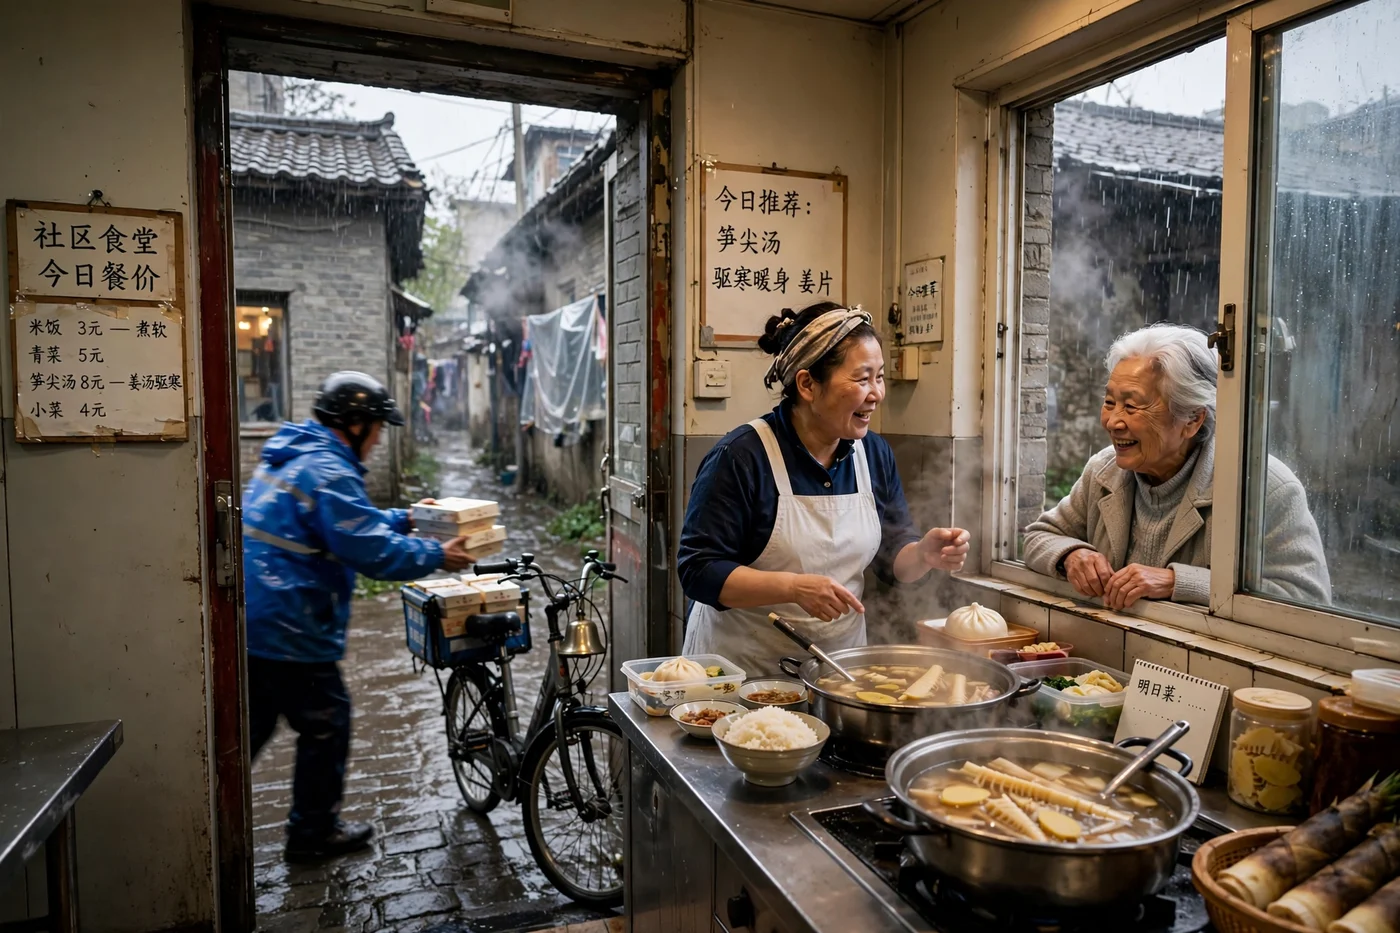
Meta · muse-image · 93.5 分
「门前小榜标餐价,巷里新炊隔院香」——门口的价目榜、墙上的今日推荐、雨巷里的蓝衣骑手、隔窗笑语的白发老人,一样不落。评委称道「门窗双框分出急缓两种节奏」;榜上「煮软」「姜汤驱寒」四字正扣颔联,画面文字拿了满加分。
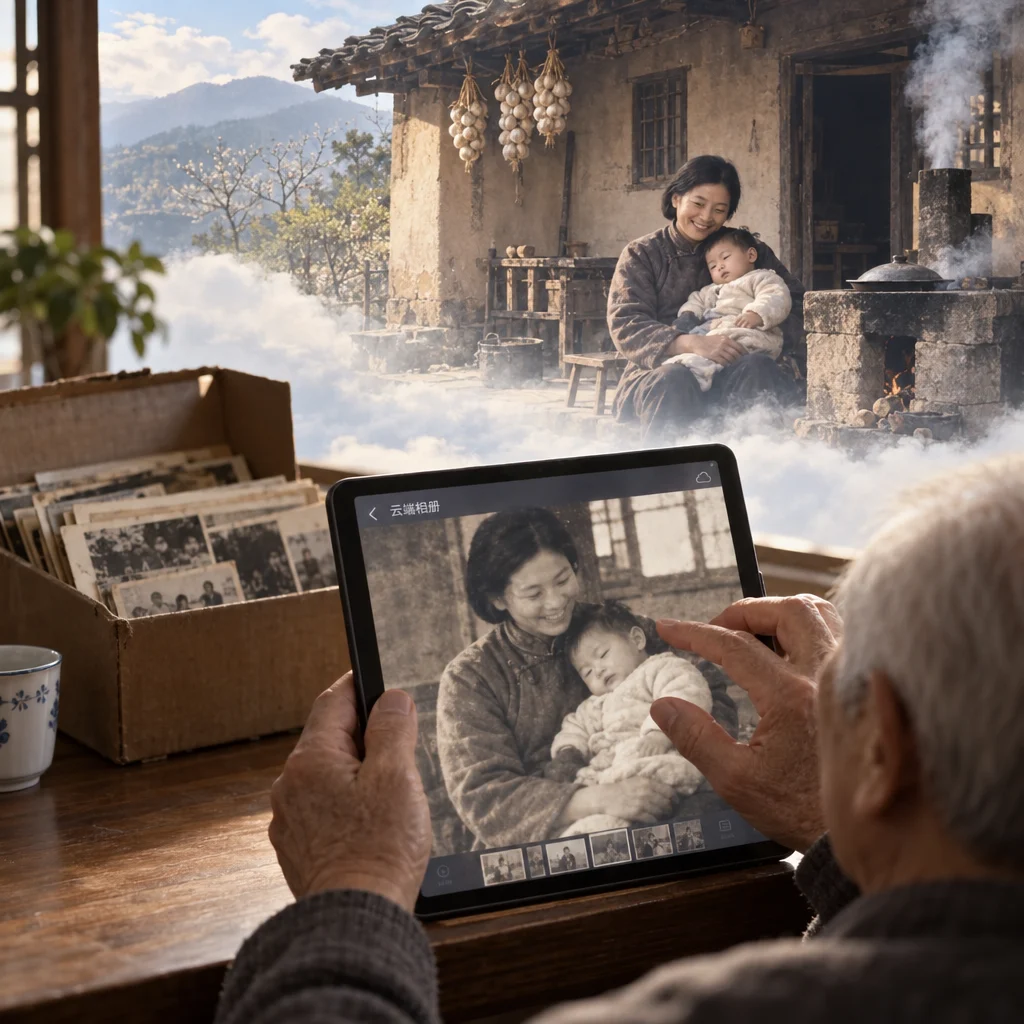
OpenAI · gpt-image-2.5-sunburst · 93.4 分
「旧照离箱寄远天,开屏又立故堂前」——纸箱里的老照片、平板上的黑白影像、云雾中浮出的老屋灶烟,三层递进把「云端」画成了真正的云。七位评委中六位意境给到 9 分以上,评语「把记忆可视化」。
评分标准
《诗画评比标准 v1(2026Q3)》由七家看图评委两轮德尔菲定出,季内冻结、每季重定。总分=四维加权+加分-减分,折 0–100。
- 意境情感 34%。情调、诗眼与言外之意是否由画面关系生成,不靠物件堆砌;留白按功能评,不按空白面积。
- 意象物象 33%。诗中名物、身份与关键性质是否画对,不要求逐词全画。
- 时空场景 22%。时令朝暮、方位远近、动作施受是否与诗相合;七言形式本身不构成古代设定。
- 画面质量 11%。可辨、自洽;不以写实精细、水墨、古雅或汉字书写为统一标准。
- 加减分。神来之笔 +0~3、得体题款 +0~3;乱码伪字或错字 −0~4、时代名物穿帮 −0~3、肢体畸变等生成缺陷 −0~4。
- 三条通则。同一偏差只计一次;题款不能补足没画出的意象;换一首同题材诗也成立的画判低分。
评委宽严
七家看图评委的尺度差异悬殊。本榜不剔除任何评委,而是先减去各自的尺度偏移再取共识 —— 与诗评榜同法,宽严不左右名次。
| 评委 | 公司 | 平均给分 | 尺度偏移 | 评图数 |
|---|---|---|---|---|
| glm-5v-turbo |  智谱 | 75.3 | +7.77 | 140 |
| gpt-6-astra | OpenAI | 69.3 | +6.73 | 140 |
| qwen3.8-max | 阿里 | 69.2 | +6.27 | 140 |
| claude-fable-5.1 |  Anthropic | 65.2 | +0.12 | 160 |
| gemini-3.8-flash | Google | 64.1 | -1.96 | 140 |
| deepseek-v4-flash-vision |  深度求索 | 63.9 | -1.44 | 160 |
| doubao-seed-2.1 | 字节 | 50.4 | -17.29 | 140 |
方法要点
- 原诗直给,不改写。各家拿到的输入完全相同:诗题、诗句原文、同一份评分标准摘要,外加一句「请依此诗作画」。不把诗改写成场景描述,不追加风格词 —— 考的是模型自己读懂格律诗的能力。
- 画题先过引擎。画题全部是语言模型现场创作、经确定性规则引擎逐字核验合格且中二联对仗的近体诗,无第三方著作权。本期有一首画题在发布前复核出律,已按同题次高替换并重新出图、重评。
- 双盲。评委看不到画作出处;送评前统一缩放、统一重编码,抹掉各家编码器指纹;评委不得臆测出处。一家参赛模型画面带固定生成标识,以本地图像修复只涂除标识一小块,不裁边,处理前后原图均留存。
- 一诗一次,同屏横比。同一首诗的全部画作放进同一次调用逐幅打分,同题基准完全一致。同一厂商的评委不评本厂画作,且那幅画不放进调用,避免同屏对比效应。
- 图序打乱与位置校正。每位评委在每首诗上的图序各不相同、可复现。检验仍发现排第一位的画系统性偏高(校正前回归斜率 -0.691 分/位,t=-2.50),故按位次回归残差扣除后计分;校正后 t=0.00,效应消除。
- 区间为准。席位分附 bootstrap 95% 置信区间,区间重叠视为统计并列;同分即并列,名次按 1、1、3 记。
- 本期局限,如实记录。各家接口默认分辨率不一(1024×1024 至 1792×2400),下期起统一 1024×1024;多数席位不支持固定随机种子,故本期固定题目、不固定随机性,逐图像素级复现做不到。
- 费用公开。本期出图与评图实际支出约 29.9 美元;换席、换题作废的旧轮费用不计入。全程零内容拦截,三次网关偶发失败各重试一次通过。
- 费用:出图 ≈$6.05、评图 ≈$23.5,逐席、逐评委明细见成本榜「诗画榜成本」;成本只作参考,不计入名次。
画题 20 首、全部画作、逐图逐评委打分与每家一好一差的例图,随十月诗才榜开卷一并公开。完整八条设计原则见 榜单设计原则。